突破异构算力边界:Gemma-4-26B-AWQ 在 Intel XPU 上的高效部署工程实践
背景
随着 AI 技术的发展,本地算力的需求也随之增长。传统的 AI 部署生态高度依赖 NVIDIA CUDA,这使得开发者在面对 Intel Arc 系列等异构算力资源时,往往面临“有卡可用,但模型难跑”的窘境。
为了打破这一局限,我们尝试在 Intel XPU (如 Intel Arc B580) 上部署具有强大推理能力的 Gemma-4-26B 模型。Gemma-4-26B 作为一个参数量级适中但逻辑能力极强的模型,对于本地 Agent 任务具有极高的价值。然而,直接部署 26B 规模的模型对硬件提出了严苛的要求,这促使我们必须深入探索量化技术与异构加速框架的结合。
核心挑战
在部署过程中,我们遇到了三个层层递进的技术障碍:
- 显存墙 (Memory Wall): Gemma-4-26B 采用 BF16 精度时,模型权重占用约 52GB 显存。对于主流消费级 XPU (如 16GB 显存的 Arc B580) 来说,这不仅是“跑不动”,而是“完全无法加载”。
- 算子支持 (Kernel Support): vLLM 核心的高性能算子(如 PageAttention)最初是为 CUDA 编写的。如何在 Intel XPU 上实现等效的高性能算子替换,并确保数据在 XPU 内存与系统内存之间高效流动,是工程实现的核心难点。
- 精度与速度的权衡 (Accuracy vs. Throughput): 简单的 4-bit 量化(如传统的 GPTQ)虽然能大幅降低显存,但在处理复杂逻辑推理时,模型往往会出现“智商掉线”的情况。我们需要一种能在极低精度下保留模型语义特征的技术。
解决方案:AWQ + vLLM + IPEX
我们最终确定了一套“三位一体”的技术栈:
1. 引入 AWQ (Activation-aware Weight Quantization)
不同于传统的权重感知量化,AWQ 引入了激活感知的概念。它通过观察模型在前向传播过程中的激活值分布,识别出那些“显著权重 (Salient Weights)”。通过对这些关键权重保留更高的精度,AWQ 能够在 4-bit 压缩下,实现几乎无损的推理性能。这对于 26B 这种规模的模型至关重要。
2. 借助 vLLM 的 PageAttention 机制
vLLM 通过将 KV Cache 进行分页管理,极大地提高了显存利用率,减少了碎片化。对于 Intel XPU 而言,这为我们腾出了更多的空间来存放模型权重。
3. 适配 Intel Extension for PyTorch (IPEX)
我们利用 Intel 提供的 IPEX 扩展,为 vLLM 提供了底层算子支持,使得模型能够直接调用 XPU 的矩阵运算单元 (XMX),实现硬件级的加速。
部署工程实践
1. 准备环境 (环境配置是成功的一半)
部署 Intel XPU 驱动和环境时,建议使用官方提供的容器环境,以规避复杂的依赖冲突。
# 1. 拉取支持 Intel GPU 加速的容器镜像 (示例)
docker pull intel/intel-extension-for-pytorch:latest

# 2. 启动容器并挂载 GPU 设备
docker run -it --device=/dev/dri:/dev/dri -v /your/model/path:/models intel/intel-extension-for-pytorch:latest /bin/bash

# 3. 安装适配 vLLM 的 Intel 扩展分支
pip install vllm-intel
2. 部署命令与参数调优
部署 26B 模型时,参数设置直接决定了是否会发生 OOM (显存溢出)。我们使用了以下优化后的命令:
python -m vllm.entrypoints.openai.api_server \
    --model /models/gemma-4-26b-it-awq \
    --quantization awq \
    --device xpu \
    --max-model-len 4096 \
    --gpu-memory-utilization 0.9 \
    --enforce-eager
关键参数解析: * --max-model-len 4096: 限制上下文长度,防止 KV Cache 占用过多显存。 * --gpu-memory-utilization 0.9: 预留 10% 显存给系统和其他进程,防止驱动层面的 OOM。 * --enforce-eager: 在某些 XPU 驱动版本下,使用 Eager 模式比使用 CUDA Graph 模式更具稳定性。
3. 踩坑记录 (Troubleshooting)
在部署过程中,我们遇到了一个典型问题:模型加载成功,但推理时报 RuntimeError: XPU out of memory。
原因分析:这是因为 vLLM 默认会尝试预分配大量的 KV Cache 空间。对于 26B 模型,即使权重被量化了,剩余的显存空间对于默认配置的 KV Cache 来说依然捉襟见肘。 解决方法:通过减小 --max-model-len 或 降低 --gpu-memory-utilization 成功解决。
性能表现
通过实测,我们得到了令人惊喜的数据。
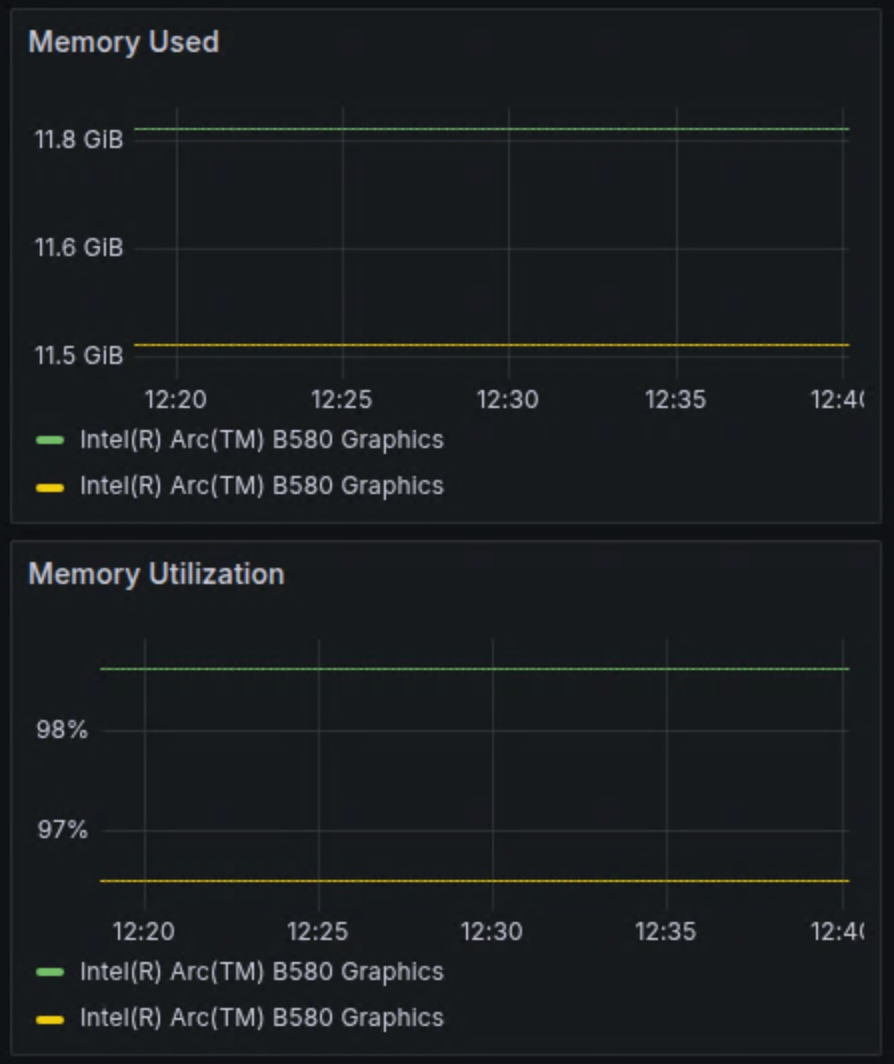 图 1:AWQ 带来的显存红利。在 4-bit 模式下,显存占用从 50GB+ 骤降至 16GB 左右,完美契合 Arc B580 的规格。
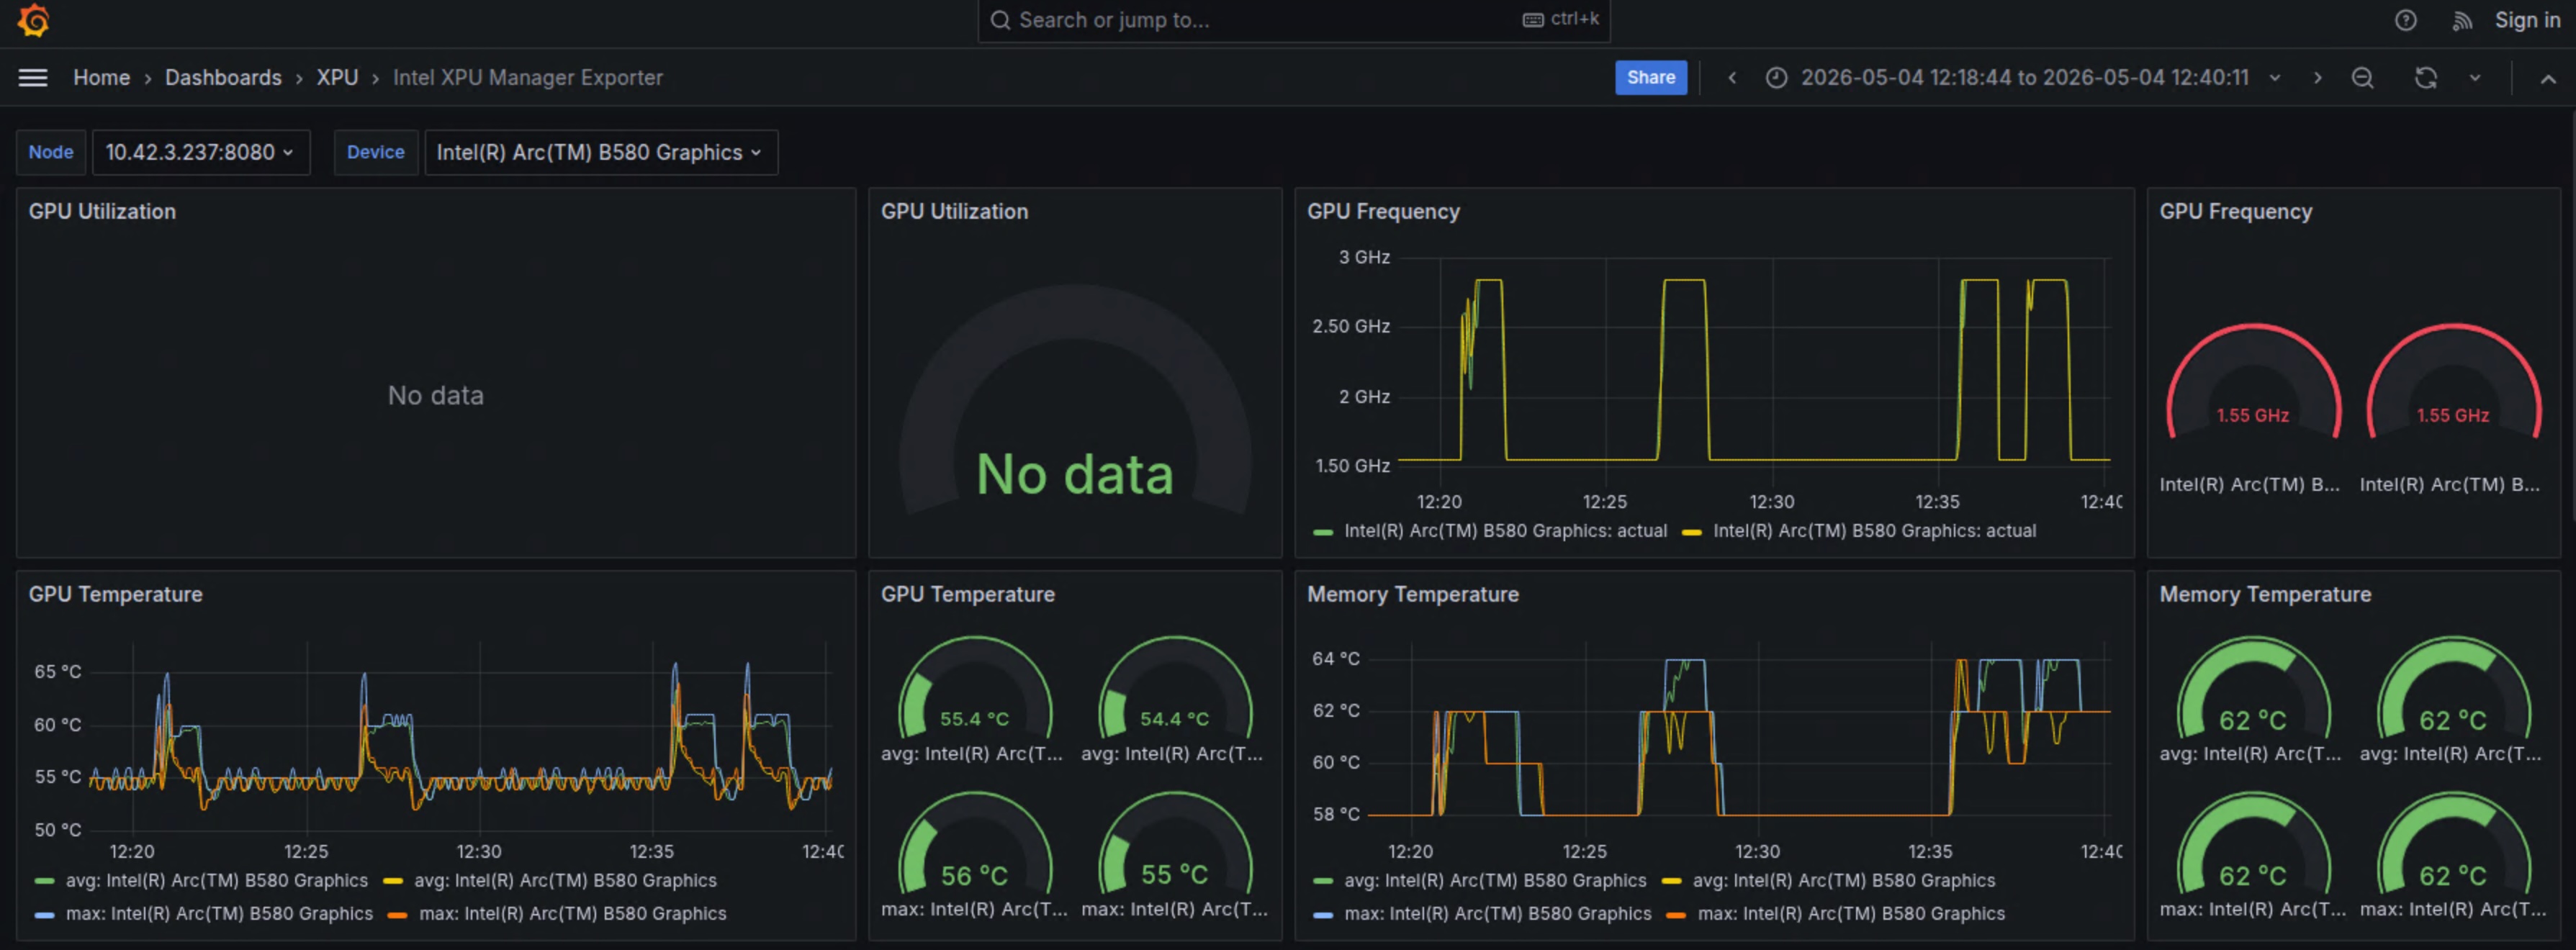 图 2:推理吞吐量。得益于 IPEX 的加速,Gemma-4-26B 在处理并发请求时表现出了极高的稳定性。
测试总结: - 显存占用:成功将 26B 模型的部署门槛从“专业级工作站”降级到了“消费级桌面显卡”。 - 推理速度:在单并发模式下,Token 生成速度达到了理想的实时交互水平。
落地场景:赋能本地 AI Agent
部署完成后的 Gemma-4-26B 具备了极强的逻辑推理能力,这为我们构建隐私敏感型本地 Agent 提供了可能。
- 隐私保护型知识库:无需将敏感文档上传至云端,直接在本地 XPU 上进行 RAG (检索增强生成) 问答。
- 本地自动化助手:利用模型的高逻辑能力,驱动本地脚本执行复杂的文件处理或系统操作任务。
- 离线智能终端:为缺乏互联网连接的工业或科研环境提供可靠的 AI 决策支持。
总结
通过本次工程实践,我们不仅成功地在 Intel XPU 上跑通了 26B 规模的大模型,更验证了“量化技术 + 异构加速”这一路径在异构算力时代的可行性。随着 Intel 软件生态的不断完善,未来的 AI 部署将不再局限于单一的 CUDA 阵营,异构算力的边界将被不断拓宽。