零代码、小样本、快速商用:模型训练流水线实战验证
<200 张样本图、半小时内出结果:一块消费级显卡 Intel B580,无需写代码,流水线式炼出商用级模型
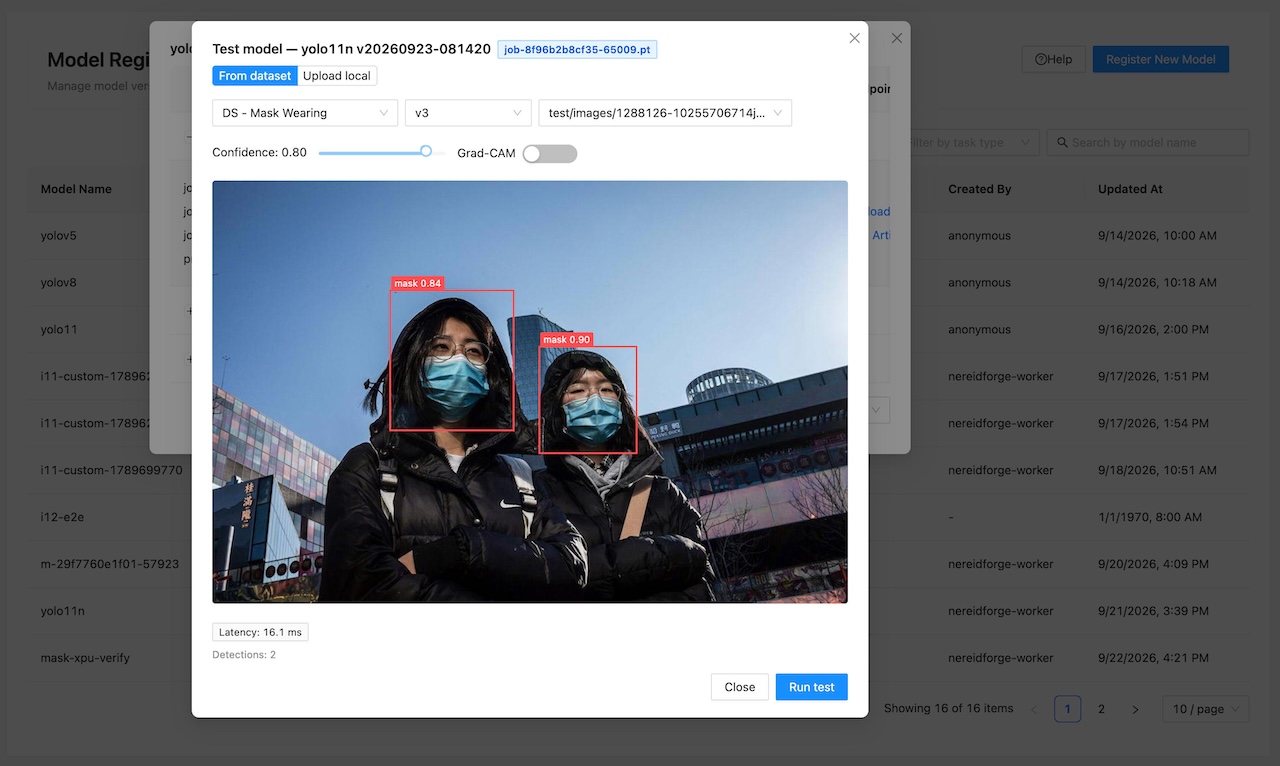
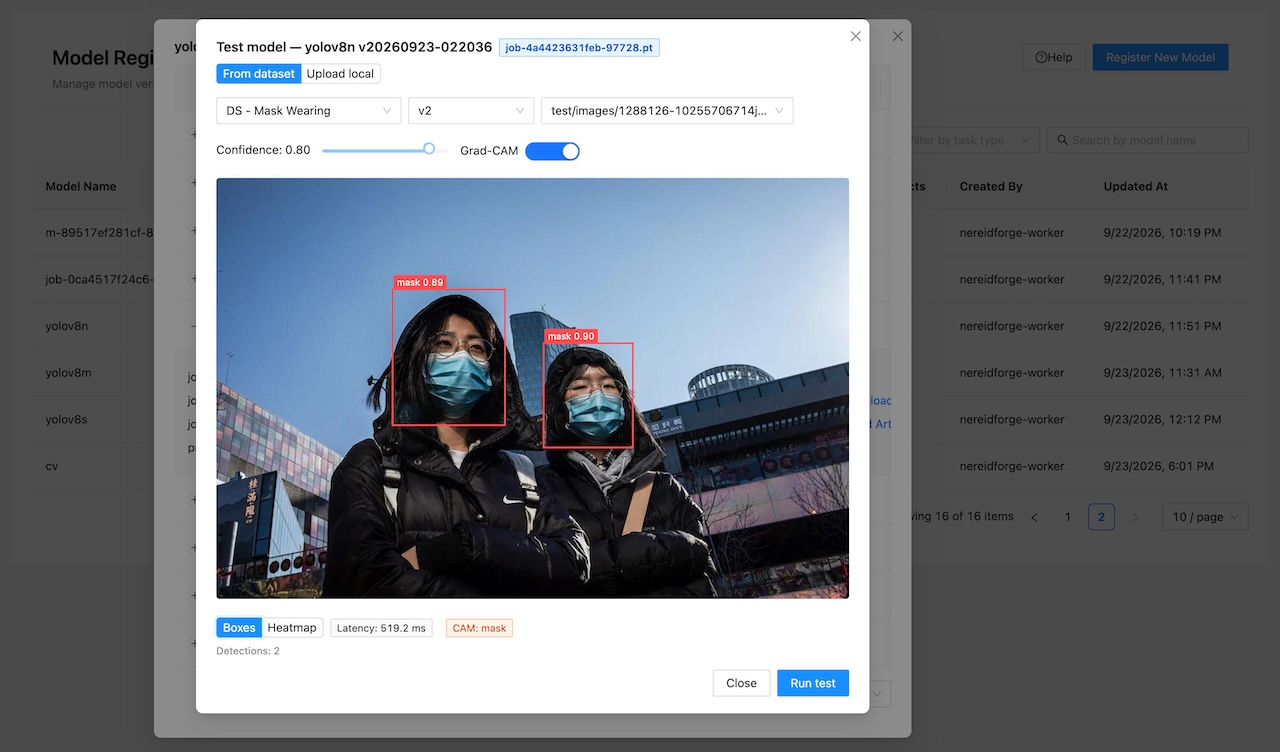
我们基于开源口罩识别数据集,仅用 149 张人工标注图片加上 20 余张未标注的背景图片(合计不到 200 张样本),在单块消费级显卡 Intel B580 上,通过一套零代码的训练流水线完成了从数据导入、模型训练到效果评估的完整流程,全程耗时不超过 30 分钟,检测精度从 51% 提升至 83%,跨过了商用级门槛。整个过程中我们先后进行了 6 轮快速迭代,其中两个反直觉的发现格外值得关注:
- 一是样本量不足时并非模型越大越好,轻量模型(YOLOv8n / YOLO11n)反而凭借更少参数避免了过拟合、表现优于大模型;
- 二是我们额外加入的未标注背景图片并没有浪费,反而帮助模型学会了区分"哪些是目标、哪些不是",显著降低了误报。这次验证的意义不止于得到一个可用的口罩检测模型,更在于证明了一件对业务和管理者都有价值的事:当训练模型不再依赖海量数据、昂贵算力与专职算法工程师,而是被压缩成一条半小时可复跑的流水线时,业务的智能化就从漫长的排队等待,变成了可随时就地启动的能力。我们计划将这条被验证过的路径复制到安全帽检测、质检缺陷识别等更多真实业务任务上,并持续公开实测结果。
目录
引言:三个"不可能",一次做完
先亮结论。我们把一个"AI 检测模型"从零到可用,做到了三个数字:
- <200 张样本图片(其中 149 张标注,20 余张补充)
- 半小时内走完全部流程
- 检测精度从 51% 提升到 83%(提升超过 30 个百分点)
更关键的是:全程没有写一行代码。使用的是一块 Intel B580 消费级显卡,不是数据中心里的昂贵显存怪兽。
这个结果想回答一个许多业务和管理者都关心的命题:在数据很少、资源有限、又不依赖专职算法工程师的情况下,我们到底能不能、能在多短时间内拿到一个可用的模型?
答案写在后面:可以,而且快的超乎想象。
背景:小样本训练是业务侧的常态
聊 AI 落地的文章总是讲"大数据""大算力"。但真实业务里,绝大多数场景的起点是:
- 数据少:标注样本往往只有一两百张,不可能攒出上万张再去训练
- 人更少:业务部门没有专职算法工程师,连"跑通训练"都是一种奢求
- 预算有限:没有多卡集群,只有一台带消费级显卡的机器
过去,这三件事任何一个都会让"自训模型"项目直接流产。传统路径是:提交需求 → 等算法工程师排期 → 漫长的数据清洗和调参 → 两三个月后得到一个未知精度的模型。与其说这是技术瓶颈,不如说是组织瓶颈。
所以我们想做一次验证:把"训练模型"这件事,从研发黑箱变成人人可操作的流水线。
挑战:我们在刻意降低一切门槛
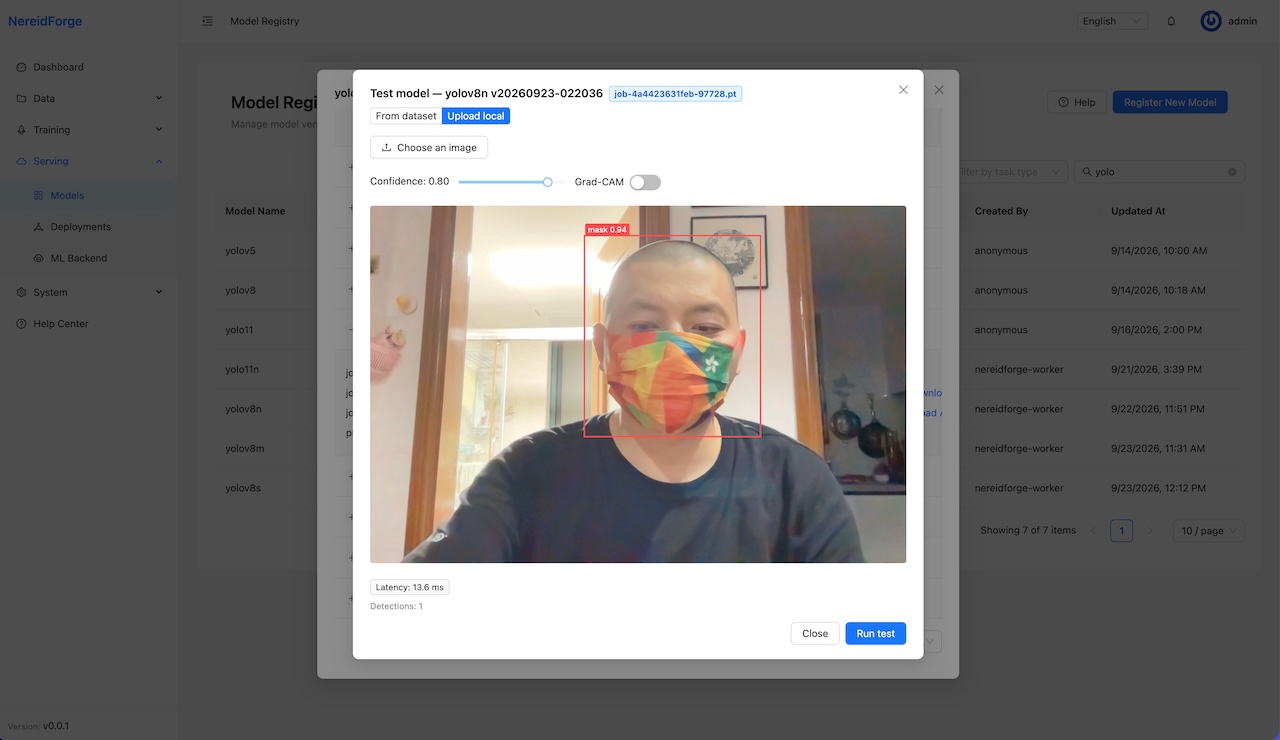
这次验证不是选了个简单任务,而是选择了一个有代表性的真实任务:口罩检测——识别图片里有没有人、有没有正确佩戴口罩。数据集来自开源 Mask Wearing 口罩识别数据集,我们只用了它的很小一部分。
刻意压低的几个条件:
| 条件 | 实际情况 | 意味着什么 |
|---|---|---|
| 训练数据 | 149 张标注图 + 20 余张未标注图,约 170 张 | 远小于业界动辄上万张的常态 |
| 算力 | 单块 Intel B580 消费级显卡 | 一台普通台式机的水平 |
| 人力 | 全程零代码,界面点选操作 | 不需要算法工程师在场 |
| 时间 | 全流程不超过 30 分钟 | 甚至可以在一场会议内完成 |
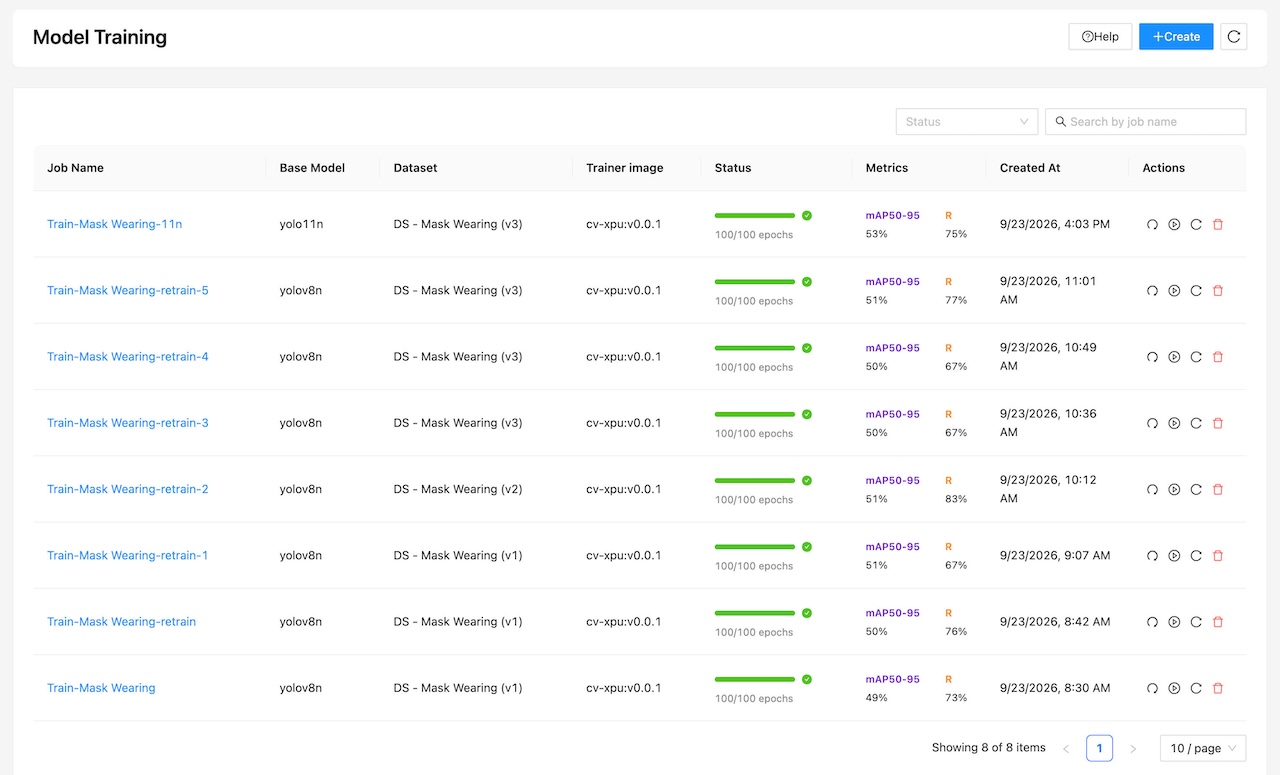
一个值得录下的事实:我们前后总共跑了 6 轮训练,目的不是"碰运气",而是验证流水线能否支撑快速迭代——每次围绕超参数和数据处理做小幅调整,立即重跑对比。这在传统研发流程里,往往意味着数周的返工。
过程:半小时内的全流程,长什么样
整个过程像一条标准的生产线,每个环节都在界面上完成,全程没有打开过一次命令行:
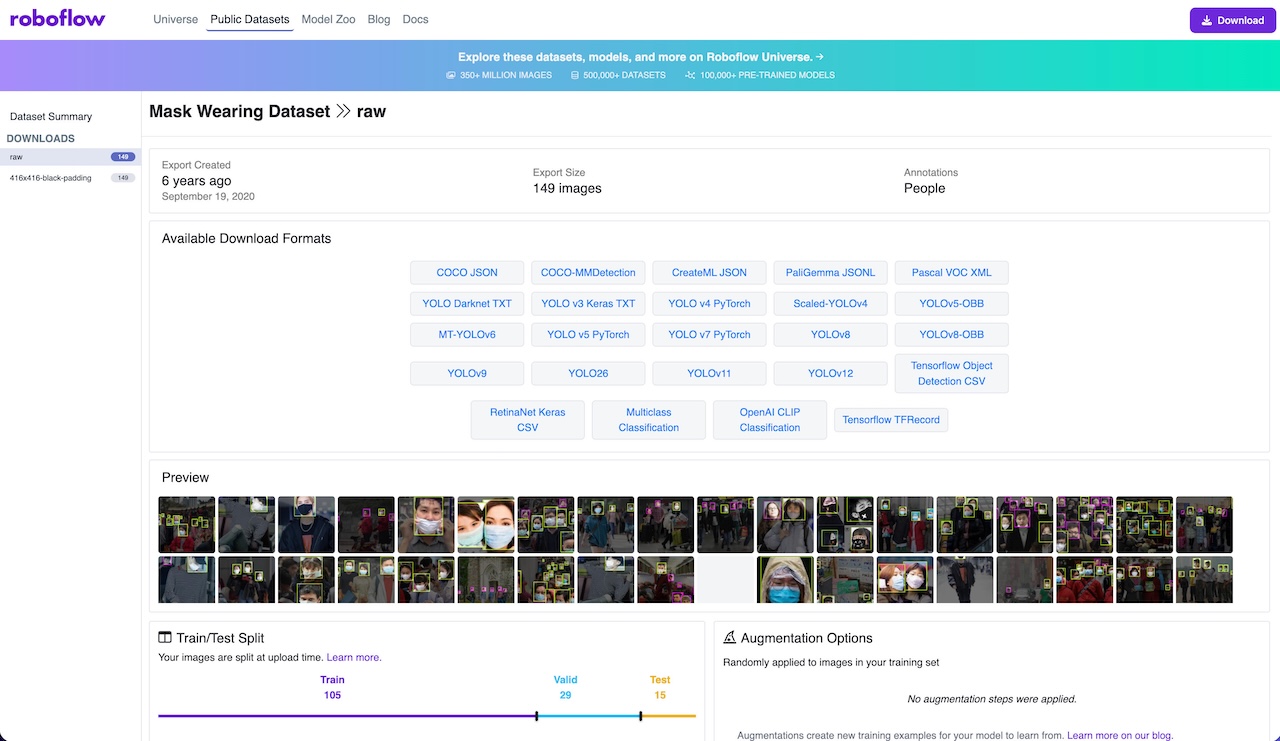
① 导入与整理(约 5 分钟)——数据集上传到流水线,自动完成格式整理与版本管理,每张图都有清晰的血缘记录:来自哪里、谁标注的、何时导出的。
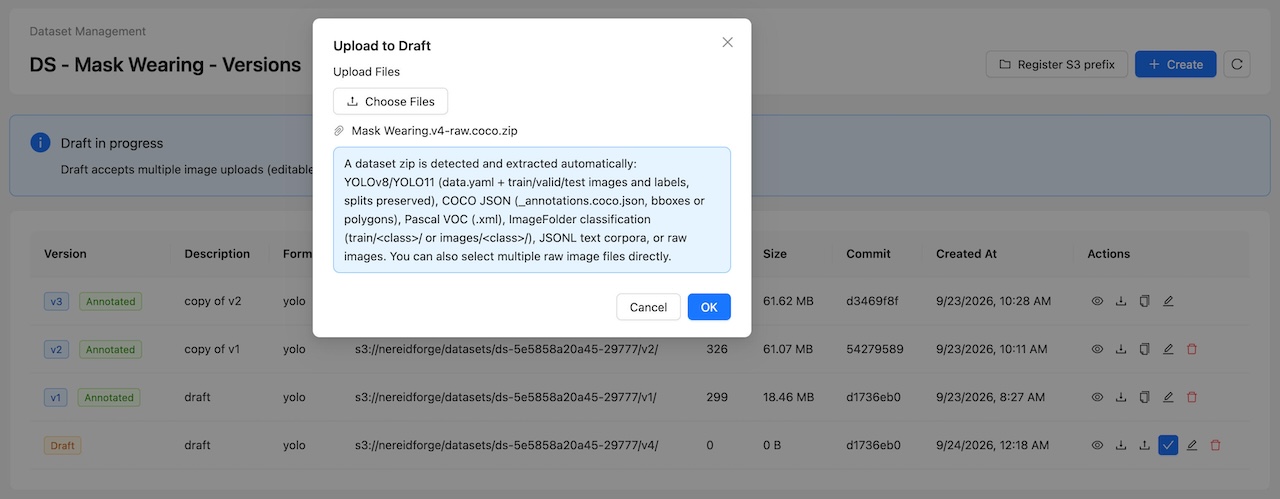
② 标注与增强(计入准备阶段)——149 张人工标注作为起点,另外加入 20 余张未标注图片作为背景补充。未经人工标注的背景图也能进入训练集,这一点我们在下文的"反直觉发现"里专门展开。
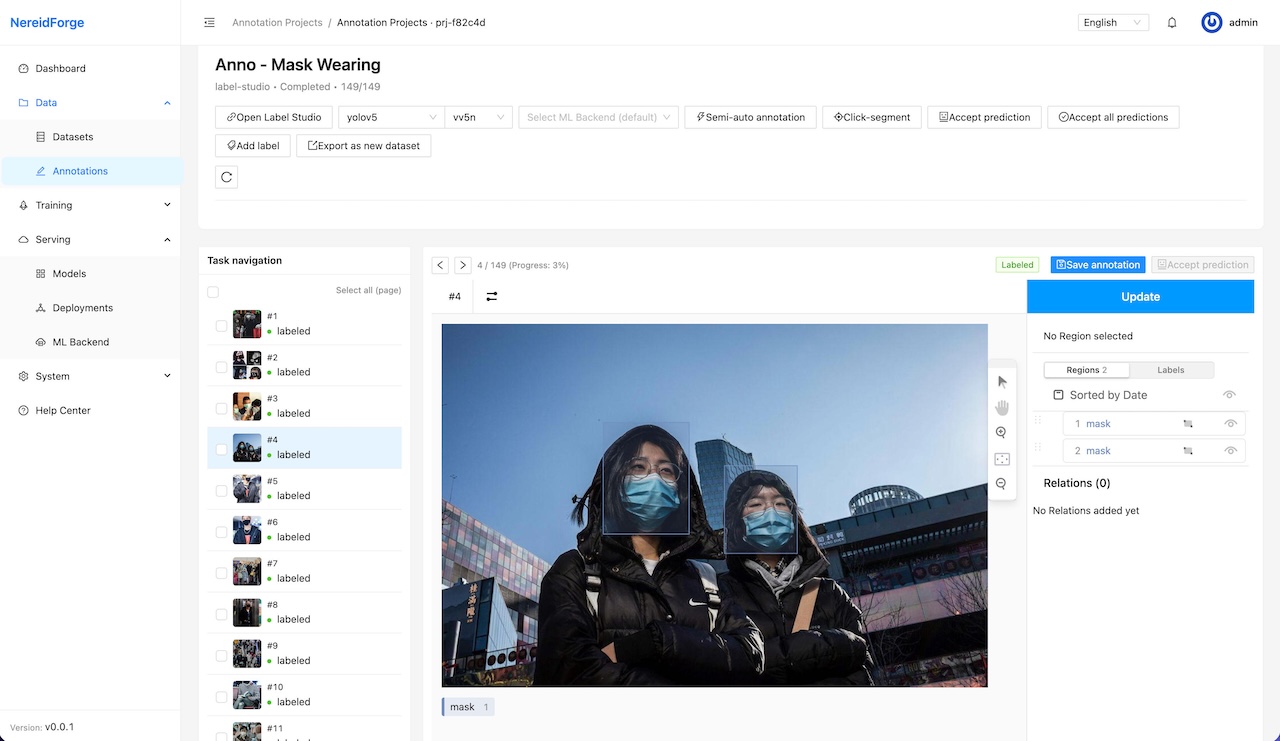
③ 训练(约 20 分钟)——选模型、点启动,六轮训练依次进行。模型、超参数、所用数据自动存档,方便逐轮对比。
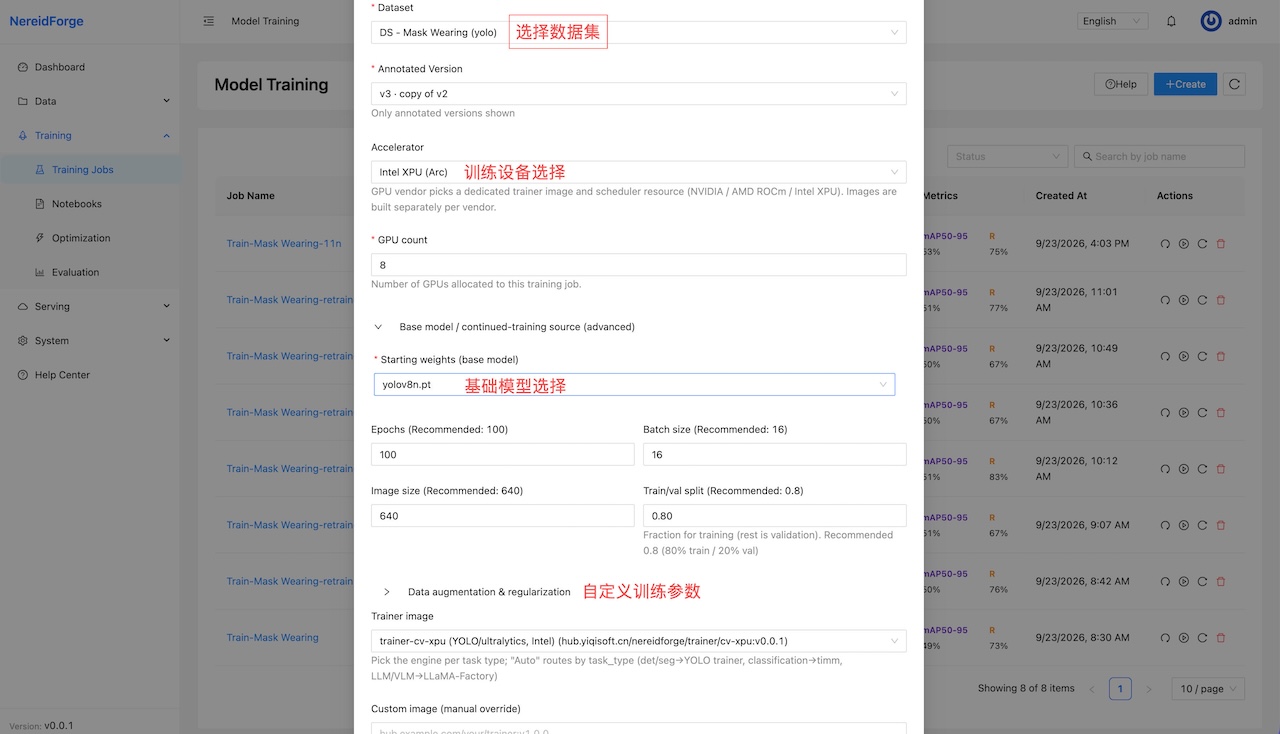
④ 评估与产出(约 5 分钟)——精度报告自动生成,达标后模型直接产出为可部署的制品。
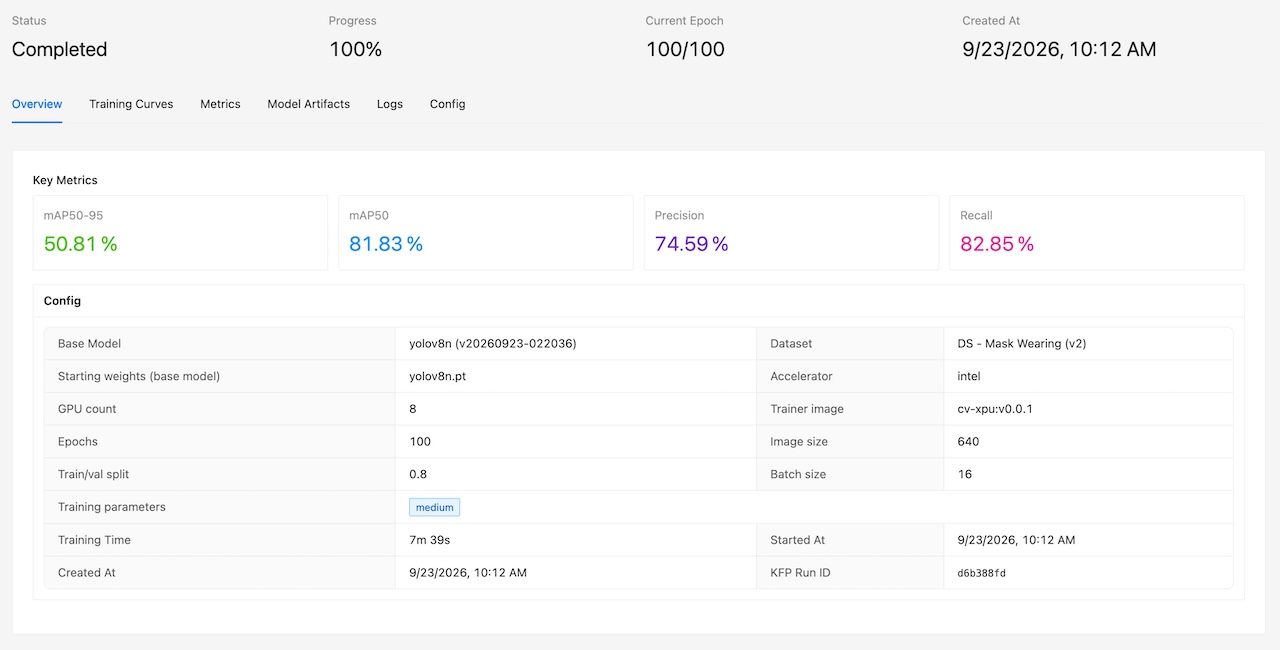
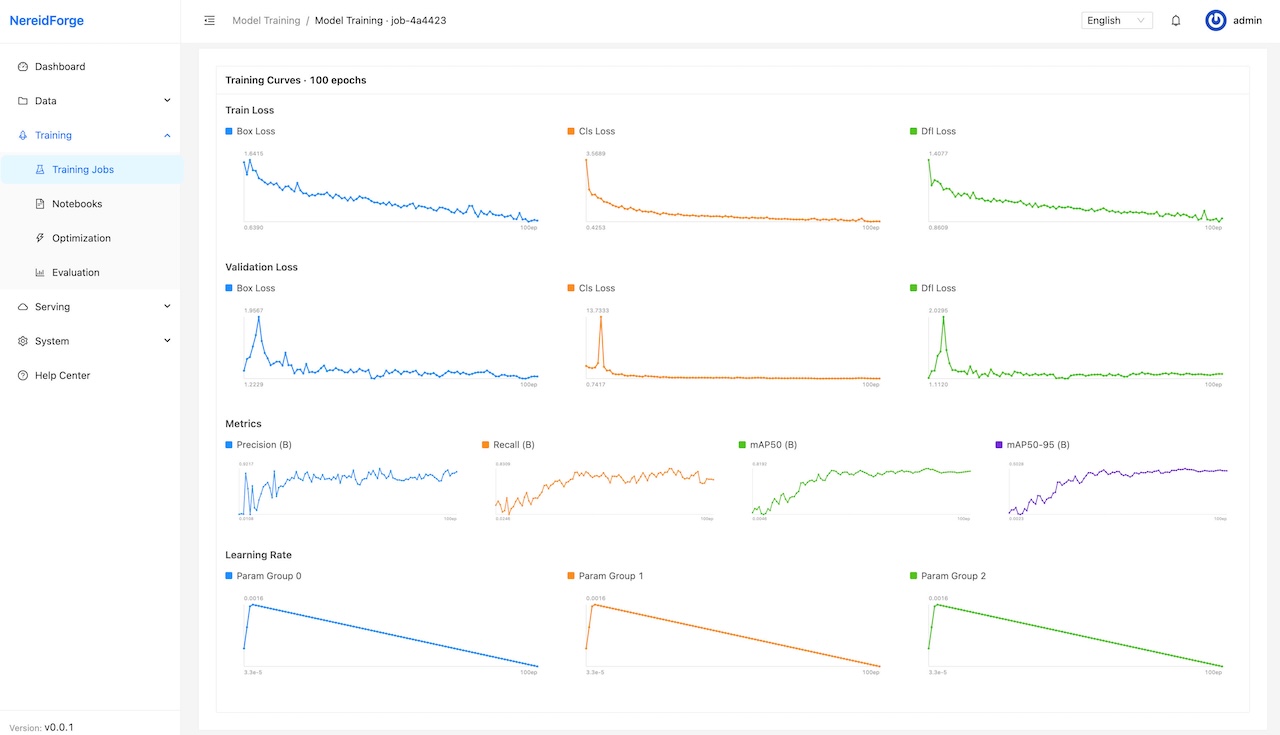
核心逻辑只有一句话:把"训练模型"从一个依赖个人经验的黑箱,变成一个参数可见、过程可查、结果可复制的流水线。
反直觉发现 1:数据少的时候,模型不是越大越好
第一轮我们按直觉选了更大的模型(YOLOv8m),想着"大模型能力更强"。结果恰恰相反——在不足 200 张样本的情况下,更大的模型效果反而更差。
原因说穿了并不神秘:样本太少,"大模型"读不到足够的知识去支撑自己庞大的参数,很快就陷入对训练样本的死记硬背(专业术语叫过拟合)——训练集上表现不错,一到新图上就露馅。
相比之下,轻巧的 YOLOv8n 反而更适合小样本:参数少、更"谦逊"、学得动。我们最终切换到 YOLOv8n / YOLO11n 这一组合后,精度出现了决定性提升。
一句话结论:小数据配小模型,不是妥协,而是正确选择。
反直觉发现 2:未标注的图片,反而帮了大忙
第二个反直觉的点出现在数据侧。我们往训练数据里加入了 20 余张完全没有标注的图片。
按直觉,没有标注的图不应该教会模型任何东西。但实测结果正好相反:这些"背景图"让模型学会了分辨"哪些是目标,哪些不是"——模型在大半惩罚性地见过空旷的街道、无人场景后,才不会看见什么都以为是人脸,进而大幅减少了误报。
一句话结论:样本少时,给模型"见见世界有多大",和给它"告诉目标是什么"同样重要。
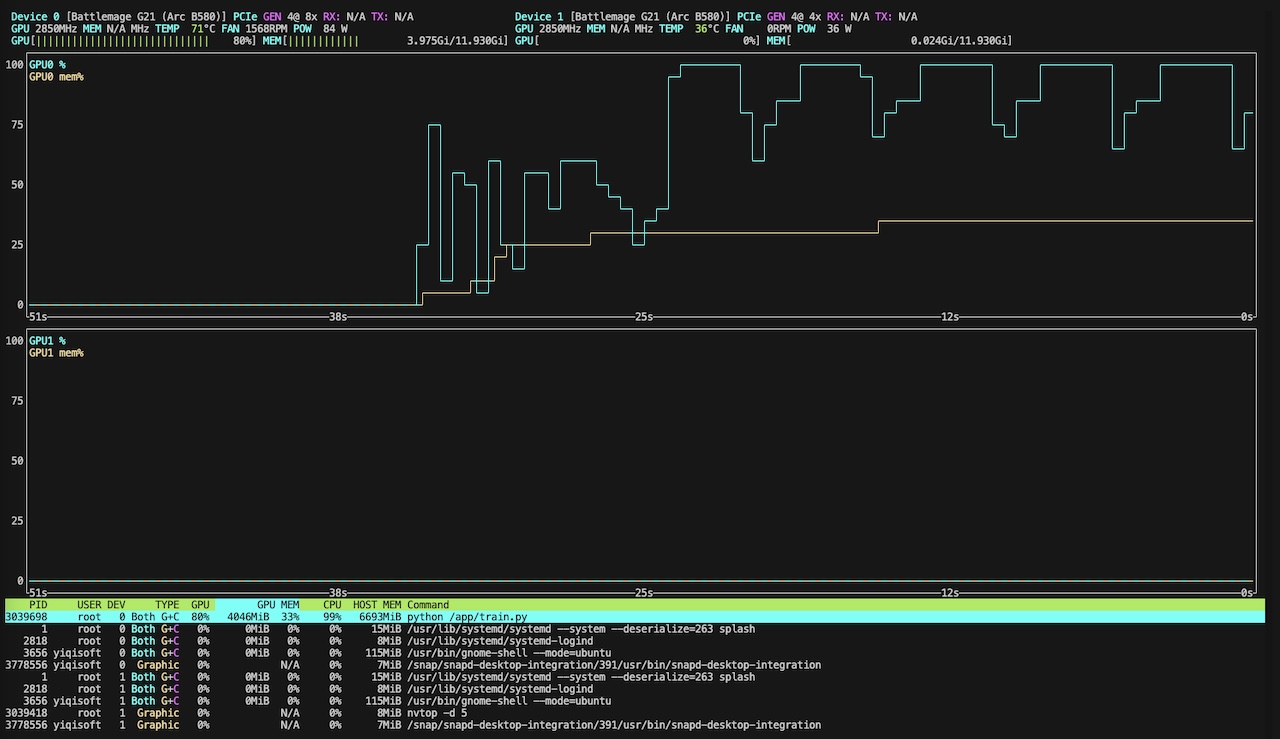
这两个发现都不是哪个专家拍脑袋想出来的,而是流水线让 6 轮实验变得足够便宜之后,用数据说话得出来的。这也是快速迭代的真正价值:让经验从"猜测"变成"验证"。
结果:51% → 83%,以及比数字更重要的事
最终结果可以从两个层面看。
数字层面:检测精度从 51% 提升到 83%,提升超过 30 个百分点。考虑到训练数据不足 200 张、总耗时不过半小时,这个精度已经跨过了商用级门槛——足以支撑门口通行、安防巡检、生产合规检查等真实业务场景。
能力层面:比模型更重要的是,我们把整个流程压缩成了一条可复用的生产线。同一个流水线,换成别的检测任务(安全帽、违禁品、质检缺陷……),同样不写代码、同样快速出结果。第一个模型是验证,第二个模型开始,就是复制。
| 维度 | 传统研发路径 | 零代码流水线 |
|---|---|---|
| 耗时 | 数周至数月 | 30 分钟 |
| 人力 | 算法工程师排期 | 业务人员即可 |
| 数据要求 | 上万张样本 | <200 张起步 |
| 算力 | 多卡集群 | 单块消费级显卡 |
| 迭代成本 | 极高,返工痛苦 | 极低,随跑随调 |
对管理者的三个启示
回头看,这次验证最大的价值并不在技术参数,而在于它对组织的启示:
其一,AI 训练应是从研发部门流向业务的产能,而不是反向的等待。 当"训练模型"不再依赖工程师排期,业务部门拿到的是"随时随地造一个模型"的能力,而不是一封"需求已排期"的回复。
其二,试错成本越低,决策质量越高。 过去做数据不足,团队会因为"返工代价太大"而不敢尝试。30 分钟一轮的迭代,让一切建立在实证之上——过拟合?加背景图?换小模型?全部跑一遍看结果。决策从"你认为"变成"数据说"。
其三,小样本、低成本是常态,而不是例外。 多数业务问题不需要海量数据和超级计算机。门槛的降低,本身就是竞争力。
结语
这次实战验证想传递的信息很朴素:模型训练的门槛,已经被流水线和消费级硬件压到了一个任何人都能触碰的位置。
不到 200 张图、一块消费级显卡、半小时、零代码——这四个词拼在一起,不是实验室里的炫技,而是我们已经真实跑通的路径。它对管理者意味着:在预算不增加、人力不增加的情况下,业务的智能化又多了一个可以就地起火的选项。
下一步,我们计划在这条流水线上继续验证更多真实业务任务(安全帽检测、质检缺陷识别等),并持续公开实测数据。欢迎关注,也欢迎用你自己的场景来检验这条流水线。
本文基于 NereidForge 模型训练流水线的真实实验记录撰写。 NereidForge 是一个专为私有化和离线环境设计的端到端 AI 模型工厂平台,它基于 k8s 集群与 Kubeflow 生态构建,提供从多模态数据标注与智能预标注、数据集版本管理,到自动化模型训练评估,再到基于 KServe 的模型注册与多租户隔离部署的全生命周期闭环;平台所有组件均通过私有 Hub 仓库分发,严格区分系统层与租户层,能够完美满足企业级无外网环境下的安全、离线交付需求。